---
title: "llms.txt et robots des IA : ouvrir votre site à ChatGPT"
description: "Quels robots des IA autoriser dans votre robots.txt (GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended, Bingbot) et ce que change le fichier llms.txt."
url: "https://bibop.ai/fr/blog/ai-crawlers-llms-txt"
---
# Robots des IA et fichier llms.txt : comment laisser ChatGPT, Perplexity et Google lire votre site
Quels robots des IA autoriser dans votre robots.txt (GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended, Bingbot) et ce que change le fichier llms.txt.
Par [Godefroy de Compreignac](https://www.linkedin.com/in/godefroy/) , Fondateur de Bibop
15 novembre 2026 · 14 min de lecture
Points clés
* Les robots des IA servent à trois usages : la recherche, les visites demandées par un utilisateur et l’entraînement des modèles. Vous autorisez ou bloquez chaque robot un par un dans votre robots.txt.
* Bloquer GPTBot, le robot d’entraînement d’OpenAI, vous retire seulement des données d’entraînement de ses modèles. ChatGPT peut toujours citer vos pages tant que son robot de recherche, OAI-SearchBot, peut les lire.
* Un hébergeur ou un pare-feu peut bloquer les robots des IA même quand votre robots.txt les autorise. Vérifiez leurs réglages après chaque changement d’offre ou d’hébergeur.
* Presque aucune IA ne lit le fichier llms.txt, censé présenter un site aux modèles de langage. Laissez votre outil de création de site le produire s’il le fait tout seul, mais ne payez pas pour en avoir un.
* Les aperçus IA et le mode IA de Google choisissent leurs sources parmi les pages que Googlebot a lues. Bloquer Google-Extended vous retire seulement de l’entraînement de Gemini et des réponses de l’application Gemini.
ChatGPT, Perplexity, Claude, Google et Copilot lisent votre site avec leurs robots de recherche : OAI-SearchBot pour ChatGPT, PerplexityBot, Claude-SearchBot, Googlebot et Bingbot. Votre fichier `robots.txt` doit les laisser passer. Vous réglez à part les robots d’entraînement, comme GPTBot ou ClaudeBot : les bloquer vous retire des données d’entraînement des modèles et laisse vos pages citables dans les réponses. Presque aucune IA ne lit le fichier `llms.txt` : Ahrefs a constaté qu’en mai 2026, 97 % de ces fichiers n’avaient reçu aucune visite. Vous trouverez ici la liste des robots à connaître, un fichier `robots.txt` à recopier, les réglages d’hébergeur qui bloquent les IA sans prévenir et ce que vaut vraiment `llms.txt`.
## Les robots des IA servent à trois usages différents
Un robot (ou « crawler ») est un programme qui visite les pages d’un site pour les lire. Il s’annonce par un nom, son « user-agent ». Vous autorisez ou bloquez chaque robot par ce nom dans votre fichier `robots.txt`. La plupart des éditeurs d’IA ont séparé leurs robots selon ce qu’ils font des pages :
* Le robot de recherche parcourt le web pour remplir l’index où l’IA cherche ses sources. Bloquez-le et vos pages ne peuvent plus être citées.
* Le robot de visite ouvre une page à la demande, quand un utilisateur pose une question ou colle un lien dans la conversation.
* Le robot d’entraînement collecte des pages qui peuvent servir à entraîner les prochains modèles. Le bloquer laisse vos citations intactes.
Éditeur
Robot de recherche
Robot de visite à la demande
Robot d’entraînement
OpenAI (ChatGPT)
OAI-SearchBot
ChatGPT-User
GPTBot
Anthropic (Claude)
Claude-SearchBot
Claude-User
ClaudeBot
Perplexity
PerplexityBot
Perplexity-User
Aucun, d’après Perplexity
Google (aperçus IA, mode IA, Gemini)
Googlebot
Aucun robot séparé
Google-Extended, une règle sans robot à part
Microsoft (Bing, Copilot)
Bingbot
Aucun robot séparé
Une préférence par page, pas de robot à part
OpenAI [décrit ses quatre robots](https://developers.openai.com/api/docs/bots). Chaque réglage y est indépendant des autres : un site qui bloque GPTBot peut toujours apparaître dans les réponses de ChatGPT, tant qu’il laisse passer OAI-SearchBot. OpenAI précise aussi qu’il faut compter environ 24 heures pour que ChatGPT tienne compte d’un changement de `robots.txt`.
Anthropic [sépare de la même façon ClaudeBot, Claude-User et Claude-SearchBot](https://support.claude.com/en/articles/8896518-what-is-claudebot). Bloquer l’un ne bloque pas les deux autres.
Perplexity affirme que [PerplexityBot ne collecte rien pour entraîner des modèles](https://docs.perplexity.ai/guides/bots).
Les robots de visite suivent des règles plus souples. OpenAI écrit que les règles du `robots.txt` « peuvent ne pas s’appliquer » à ChatGPT-User, puisqu’un utilisateur a demandé la visite. Perplexity va plus loin : Perplexity-User « ignore en général » le `robots.txt`. Ces deux robots lisent seulement la page qu’un utilisateur a demandée, au moment où il la demande, sans remplir d’index.
## Google et Bing utilisent leur robot de recherche habituel pour leurs réponses d’IA
Google n’a pas de robot à part pour ses fonctions d’IA. Les aperçus IA et le mode IA choisissent leurs sources dans l’index de Google Search, que Googlebot remplit. Une page bien indexée par Google peut donc être citée, sans autre réglage. Nous détaillons [comment Google choisit les sources de ses aperçus IA](/fr/blog/google-ai-overviews).
Google-Extended est une règle sans robot derrière : un nom que vous écrivez dans votre `robots.txt` pour dire si les pages que Googlebot a lues peuvent servir à entraîner les modèles Gemini et à nourrir les réponses de l’application Gemini. Google précise que [cette règle n’a aucun effet sur votre présence dans Google Search ni sur votre classement](https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers).
Copilot, l’assistant de Microsoft, répond à partir de l’index de Bing, que Bingbot remplit. Microsoft ne documente pas de robot propre à Copilot. Bloquer Bingbot vous retire donc à la fois de Bing et des réponses de Copilot. Microsoft [a annoncé en octobre 2026 de nouvelles préférences](https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/), à placer page par page, pour refuser l’usage de vos pages dans les réponses de Copilot sans quitter Bing :
* La balise `` retire une page des réponses de Copilot et des autres réponses de Microsoft qui s’appuient sur le web.
* La balise `` retire une page de l’entraînement des modèles.
* Ces préférences entrent en vigueur le 1er février 2027. Après le 1er mars 2027, Bing ne lira plus les balises `noarchive` et `nocache` comme des refus d’usage par l’IA.
## Quels robots laisser passer, et lesquels bloquer
Si vous voulez que les IA citent votre entreprise, laissez passer tous les robots de recherche et tous les robots de visite. Un robot bloqué empêche l’IA correspondante de lire vos pages au moment de répondre : elle cite alors d’autres sites, souvent ceux de vos concurrents.
L’entraînement est une décision à part. Un modèle qui répond sans faire de recherche se sert de ce qu’il a appris pendant son entraînement. Une entreprise bien décrite dans les données d’entraînement a plus de chances d’être nommée dans ces réponses-là. Si votre entreprise vit de demandes de devis, laissez donc passer GPTBot et ClaudeBot : vous avez plus à y gagner qu’à y perdre.
Bloquez l’entraînement si vous vendez vos textes, comme un média, un éditeur de formations ou une base de données payante. Vous gardez alors les citations dans les réponses, puisque les robots de recherche restent ouverts. Sachez que Google-Extended règle aussi les réponses de l’application Gemini : le bloquer vous en retire.
Un groupe de travail de l’IETF, l’organisme qui écrit les standards techniques d’internet, a publié le 30 octobre 2026 un projet de règle pour refuser l’entraînement en une seule ligne, sous le nom `__usage_ai-training`. Bing la respecte déjà. Google compte la prendre en charge à son tour début 2027. Gardez vos règles robot par robot jusqu’à ce que les autres éditeurs d’IA l’adoptent.
## Un fichier robots.txt qui laisse entrer les IA
Le fichier `robots.txt` se trouve à la racine de votre site, à l’adresse `https://votresite.fr/robots.txt`. Voici un exemple qui laisse entrer les robots de recherche et de visite des IA et refuse l’entraînement, si vous faites ce choix :
```
# Robots de recherche et de visite des IA : laissez-les passer
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Claude-SearchBot
User-agent: Claude-User
Allow: /
# Entraînement des modèles : gardez ce bloc seulement si vous le refusez
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /
# Tous les autres robots, dont Googlebot et Bingbot
User-agent: *
Allow: /
Sitemap: https://votresite.fr/sitemap.xml
```
Un fichier qui ne contient que `User-agent: *` suivi de `Allow: /` laisse déjà passer tout le monde. Les blocs qui nomment chaque robot rendent votre choix lisible et laissent passer les IA quand une règle générale plus stricte bloque certaines parties du site.
Relisez-le après chaque refonte
Une ligne `Disallow: /` oubliée en sortie de préproduction suffit à fermer tout le site, à Google comme aux IA. Ouvrez votre `robots.txt` dans un navigateur après chaque mise en ligne importante.
## Votre hébergeur peut bloquer les robots des IA à votre place
Certains hébergeurs, pare-feux et réseaux de diffusion (CDN) bloquent les robots des IA avant même qu’ils ne lisent le fichier. Cloudflare [bloque par défaut les robots des IA](https://cloudflare.com/press-releases/2025/cloudflare-just-changed-how-ai-crawlers-scrape-the-internet-at-large) sur les nouveaux domaines depuis le 1er juillet 2025 et demande à chaque nouveau client s’il veut les autoriser. Un site mis en ligne ou migré chez Cloudflare depuis cette date peut donc être fermé aux IA sans que personne ne l’ait décidé.
Vérifiez trois choses :
* Dans l’interface de votre hébergeur ou de votre CDN, cherchez un réglage sur les robots d’IA (« AI bots », « AI crawlers » ou « bot protection ») et regardez ce qu’il bloque.
* Dans les journaux de votre serveur, cherchez les noms OAI-SearchBot, PerplexityBot ou Claude-SearchBot. Un robot qui reçoit une erreur 403 sur chaque page est bloqué en amont de votre `robots.txt`.
* Dans votre outil de statistiques, cherchez les visites marquées `utm_source=chatgpt.com`. OpenAI [ajoute ce paramètre](https://help.openai.com/en/articles/12627856-publishers-and-developers-faq) aux liens que ChatGPT affiche.
N’importe quel programme peut se faire passer pour GPTBot en reprenant son nom. Pour savoir si une visite vient vraiment d’OpenAI, comparez son adresse IP à celles qu’OpenAI publie pour chaque robot, comme [la liste des adresses de GPTBot](https://openai.com/gptbot.json).
## Presque aucune IA ne lit le fichier llms.txt
Le fichier `llms.txt` est une proposition de Jeremy Howard, cofondateur du laboratoire de recherche Answer.AI, publiée [le 3 septembre 2024](https://llmstxt.org/). Ce fichier texte au format Markdown se place à la racine du site, présente le site en quelques lignes et liste ses pages importantes, chacune avec un lien vers une version Markdown sans menus ni scripts. L’idée était d’aider un modèle de langage à trouver l’essentiel d’un site sans parcourir tout le HTML.
De plus en plus de sites publient ce fichier. L’éditeur de logiciels Originality.ai a [compté 36 120 fichiers llms.txt en mai 2026](https://originality.ai/blog/llms-txt-tracking-study), contre 4 088 en juin 2025, sur plus de 3 millions de sites suivis.
Les IA, elles, ne le lisent presque pas :
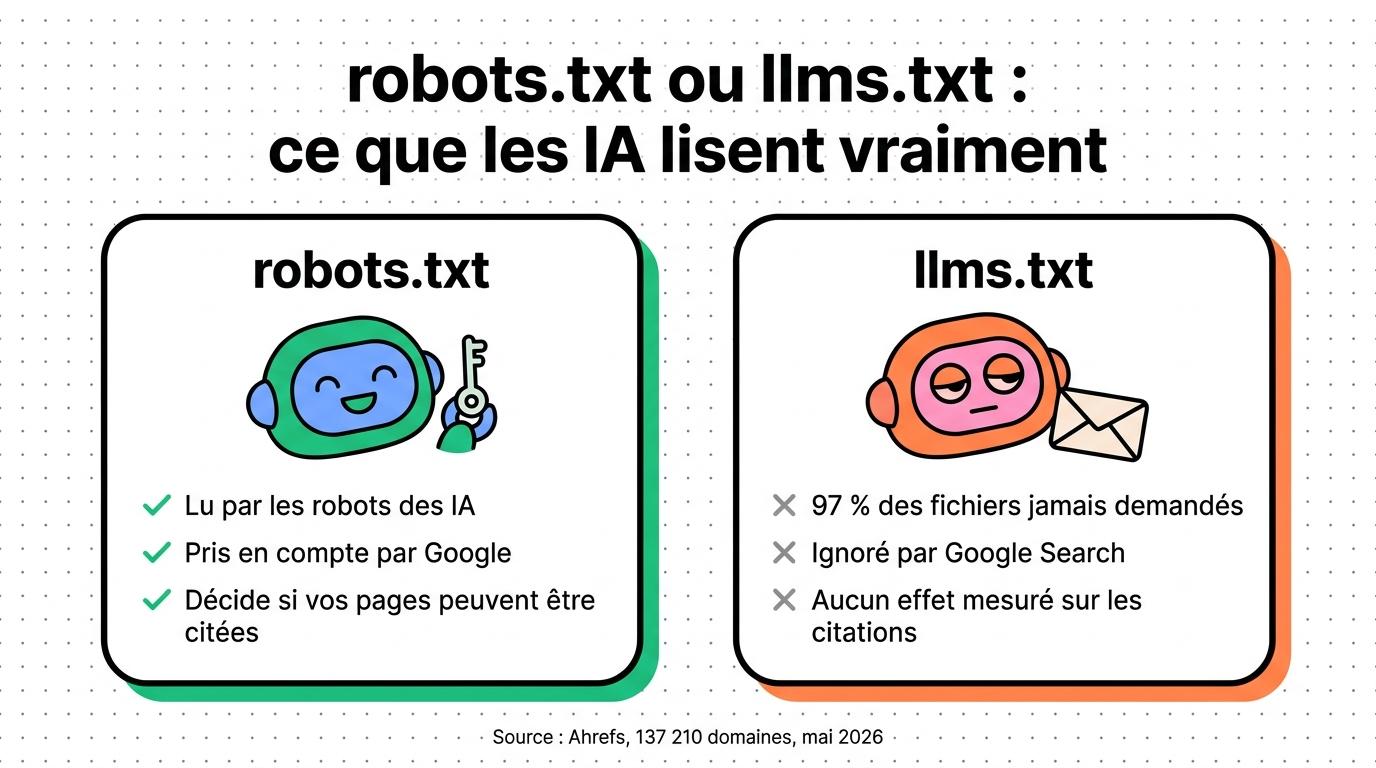
* Ahrefs, éditeur d’outils SEO, a analysé en mai 2026 le trafic de 137 210 domaines, dont environ 38 000 publient un `llms.txt`. [97 % de ces fichiers n’ont reçu aucune visite](https://ahrefs.com/blog/llmstxt-study/) pendant le mois. Les robots de recherche des IA ne représentaient que 1,1 % des visites reçues par l’ensemble de ces fichiers, loin derrière les outils d’audit SEO (21,7 %).
* Google écrit que [Google Search ignore ces fichiers](https://developers.google.com/search/docs/fundamentals/ai-optimization-guide).
* John Mueller, porte-parole de Google pour la recherche, [compare le fichier à la balise meta keywords](https://www.searchenginejournal.com/google-says-llms-txt-comparable-to-keywords-meta-tag/544804/), que Google ignore depuis des années. Selon lui, aucun service d’IA n’a dit s’en servir. Les journaux de serveur montrent même que leurs robots ne le demandent pas.
Les programmes qui lisent vraiment `llms.txt` sont surtout des assistants de programmation, qui s’en servent pour parcourir une documentation technique. D’après Ahrefs, l’outil Claude Code a demandé ces fichiers plus souvent que chacun des robots de recherche des IA. Un éditeur de logiciel qui publie une documentation pour développeurs a donc intérêt à publier ce fichier.
Le fichier ne change rien aux citations d’un site d’entreprise, mais il reste inoffensif : le site de Bibop en publie un, généré automatiquement à chaque mise en ligne avec une version Markdown de chaque page. Si votre outil de création de site le produit tout seul, laissez-le faire. Mais ne payez pas une prestation de « référencement IA » qui repose sur ce fichier. Passez plutôt une heure à vérifier votre `robots.txt` et les réglages de votre hébergeur : vous y gagnerez bien plus.
robots.txt
llms.txt
Rôle
Autoriser ou bloquer chaque robot
Présenter le site et ses pages importantes à un modèle de langage
Lu par les IA
Oui, par leurs robots de recherche et d’entraînement
Rarement, surtout par des assistants de programmation
Pris en compte par Google
Oui
Non, Google Search l’ignore
Effet sur vos citations
Décisif : bloquer le robot de recherche d’une IA l’empêche de citer vos pages
Aucun effet mesuré
Statut
Standard depuis 1994, publié par l’IETF en 2022 (RFC 9309)
Proposition publiée en 2024, sans adoption par les éditeurs d’IA
## Comment être indexé dans ChatGPT ?
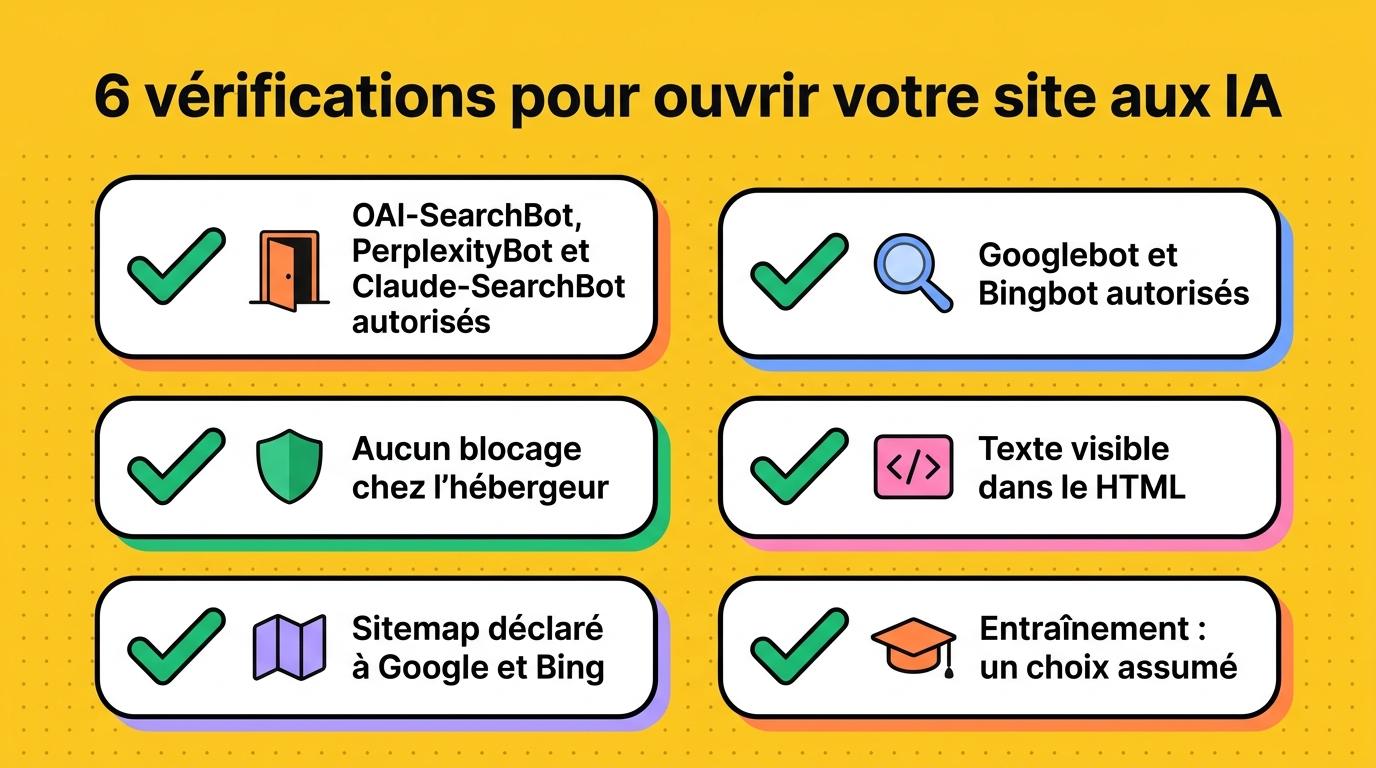
ChatGPT n’a pas de formulaire d’inscription. OpenAI indique que [tout site public peut apparaître dans les réponses de ChatGPT](https://help.openai.com/en/articles/12627856-publishers-and-developers-faq), tant qu’il laisse passer OAI-SearchBot. Une page doit remplir quatre conditions pour y être citée :
1. OAI-SearchBot peut lire la page, sans blocage dans le `robots.txt` ni chez l’hébergeur.
2. Le texte figure dans le HTML que le serveur envoie. Les robots des IA lisent ce HTML sans exécuter le JavaScript, donc un texte qui n’apparaît qu’après un script reste invisible pour eux.
3. La page est indexée par Google et par Bing. Déclarez votre sitemap dans la Search Console et dans Bing Webmaster Tools, puisque les IA s’appuient aussi sur ces index pour trouver leurs sources.
4. La page répond clairement, dès ses premières lignes, à une question que vos clients posent, avec des faits qu’ils ne trouveront pas ailleurs : vos prix, vos délais, vos cas clients.
L’accès du robot, le texte dans le HTML et l’indexation rendent la page lisible par l’IA. L’IA cite ensuite, parmi les pages lisibles, celle qui répond le mieux à la question. Nous détaillons [comment être cité par ChatGPT et Perplexity](/fr/blog/get-cited-in-ai-answers).
Pour retirer une page des réponses de ChatGPT, placez une balise `noindex` sur la page plutôt que de la bloquer dans le `robots.txt`. OpenAI précise que son robot doit pouvoir ouvrir la page pour lire cette balise.
## Bibop vérifie chaque jour l’accès des robots des IA à votre site
Bibop est un agent de visibilité sur Google et dans les IA. Il contrôle votre site tous les jours, `robots.txt` compris, vérifie que les robots de ChatGPT, Claude et Perplexity y accèdent et corrige lui-même ce qui les bloque. Il pose chaque semaine 50 questions de vos clients à ChatGPT, à Perplexity et au mode IA de Google, puis note qui est cité, vous ou un concurrent.
Bibop modifie les fichiers de votre site comme le ferait un développeur, sans script ajouté dans le navigateur : les robots des IA lisent donc exactement ce que lisent vos visiteurs. La personne qui gère votre site trouvera [le détail du branchement et de la sécurité](/fr/technical).
Découvrez [le travail de Bibop au quotidien](/fr/features), ou regardez directement [les tarifs et les garanties](/fr/pricing) : l’abonnement coûte 90 € HT par mois, sans engagement, avec le premier mois remboursé si vous le demandez dans les 30 jours.
## Vos questions sur les robots des IA et llms.txt.
Qu’est-ce que GPTBot ?
GPTBot est le robot d’OpenAI qui collecte des pages pouvant servir à entraîner ses modèles. ChatGPT trouve les sources qu’il cite grâce à un autre robot, OAI-SearchBot. Vous pouvez bloquer GPTBot dans votre robots.txt et rester visible dans les réponses de ChatGPT.
Bloquer GPTBot me retire-t-il de ChatGPT ?
Non. OpenAI traite chaque robot séparément. Bloquer GPTBot retire vos pages de l’entraînement des futurs modèles, mais ChatGPT peut toujours les citer tant qu’OAI-SearchBot y a accès. ChatGPT tient compte d’un changement de robots.txt en 24 heures environ.
Faut-il créer un fichier llms.txt ?
Non, vos pages peuvent être citées sans lui. Ahrefs a constaté qu’en mai 2026, 97 % des fichiers llms.txt étudiés n’avaient reçu aucune visite. Google Search les ignore aussi. Le fichier sert surtout aux assistants de programmation qui lisent une documentation technique. Créez-le seulement s’il ne vous coûte rien.
Google-Extended retire-t-il mon site des aperçus IA ?
Non. Les aperçus IA et le mode IA choisissent leurs sources dans l’index de Google Search, rempli par Googlebot. Google-Extended règle l’entraînement des modèles Gemini et les réponses de l’application Gemini. Pour sortir des aperçus IA, passez par le réglage sur l’IA générative de la Search Console.
Comment savoir si les robots des IA visitent mon site ?
Cherchez leurs noms (OAI-SearchBot, GPTBot, PerplexityBot, ClaudeBot) dans les journaux de votre serveur, et vérifiez qu’ils reçoivent bien vos pages plutôt qu’une erreur 403. Dans vos statistiques, les visites venues de ChatGPT portent le paramètre utm\_source=chatgpt.com.
Votre agent de visibilité, dès aujourd’hui.
Bibop écrit vos contenus, corrige votre site et vous fait connaître, tous les jours. 90 € HT par mois, sans engagement, premier mois remboursable pendant 30 jours.
[Commencer](#waitlist)
## Continuer la lecture
[
5 octobre 2026
## Être cité par ChatGPT, Perplexity et Google : le guide B2B
Ce que lisent les moteurs de réponse, pourquoi ils citent certains sites plutôt que d’autres, et les leviers concrets pour qu’une entreprise B2B apparaisse dans leurs réponses.
](/fr/blog/get-cited-in-ai-answers)[
13 novembre 2026
## AI Overview : apparaître dans les aperçus IA de Google
Comment Google choisit les sources de ses aperçus IA et de son mode IA, ce que la Search Console en montre et ce qui fait entrer une page dans la réponse.
](/fr/blog/google-ai-overviews)